Criei um jogo de fazenda do zero, com as regras que eu quis, e entreguei a partida a um LLM. Ele jogou o ano inteiro, aprendeu com os próprios erros e custou menos de dois dólares.
A ideia veio de um desafio do Kaggle, o Kaggriculture, mas eu queria fazer do meu jeito. Em vez de jogar o jogo de outra pessoa, criar o meu: definir as regras, desenhar o mapa e entender como uma IA joga aquilo.
E não qualquer IA. A pergunta era sobre modelo de linguagem, e sobre o modelo que eu quisesse usar. Um LLM consegue jogar um jogo do começo ao fim? E se consegue, quanto custa?
Um LLM consegue jogar um jogo? E quanto custa?
02
O jogo
Uma fazenda pequena, regras simples e uma restrição que manda em tudo: a energia do dia.
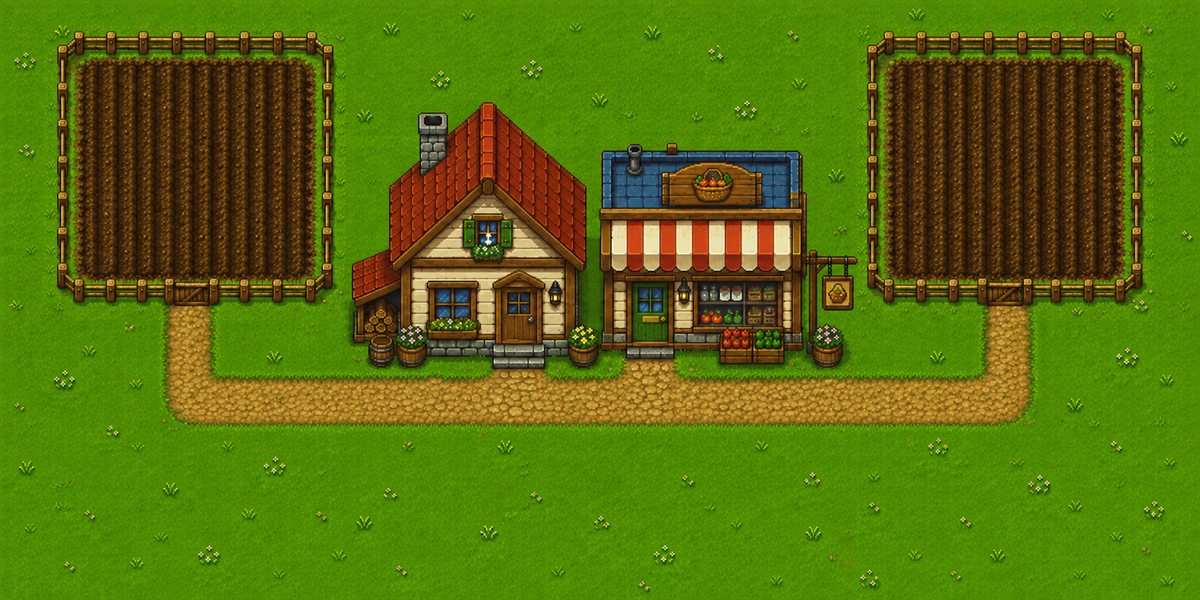
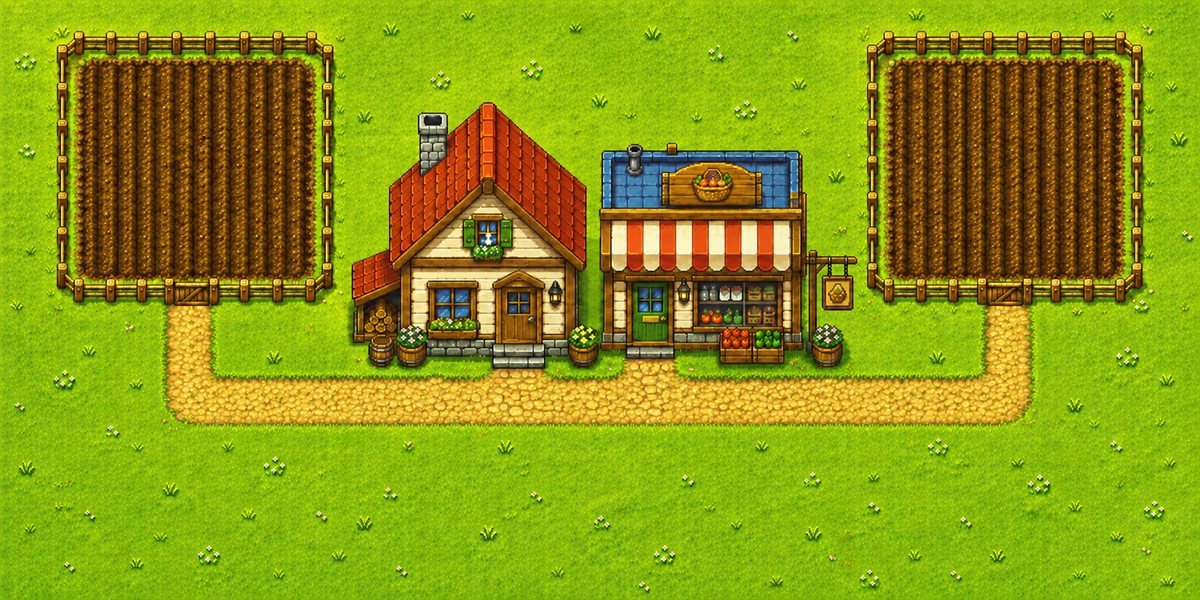
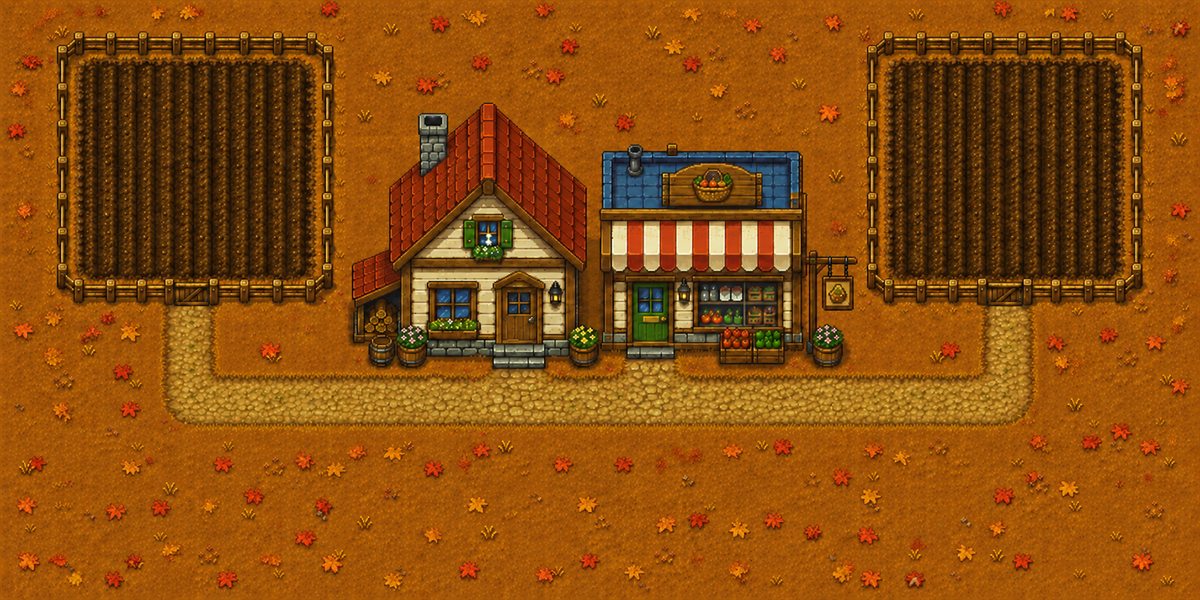
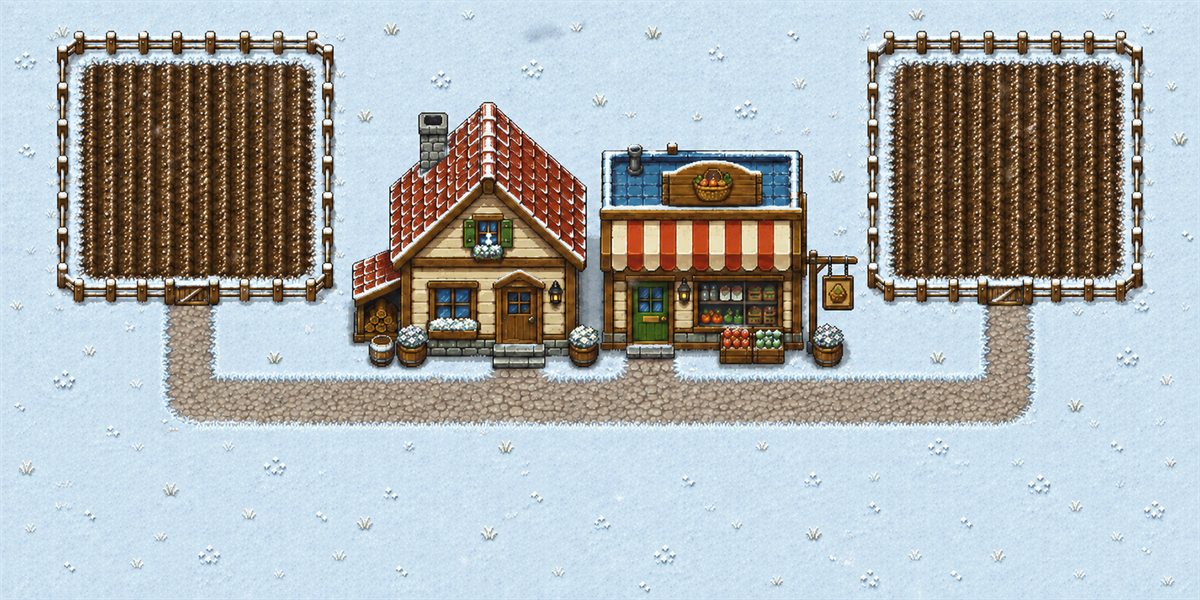
O mapa tem uma casa, uma loja e dois canteiros. O jogador planta, espera crescer, colhe e vende. São cinco cultivos, batata, cenoura, beterraba, trigo e melancia, cada um com seu tempo de crescimento, sua validade e seu preço.
Tudo gasta estamina. Andar uma célula custa 1, plantar custa 2, colher custa 1, e o dia começa com 160. Só dormir em casa recupera, e chegar a zero é derrota. Como os canteiros ficam longe da casa, o problema de verdade é o caminho.
O ano tem 120 dias em quatro estações, e cada uma muda crescimento, validade e preço; no inverno nada se planta. A loja tem estoque, promoção e um caixa diário, e o preço cai se você vende demais da mesma coisa. Uma semente fixa repete o cenário inteiro, o que permite pôr dois modelos para jogar exatamente a mesma partida.
Primavera, dias 1 a 30
Verão, dias 31 a 60
Outono, dias 61 a 90
Inverno, dias 91 a 120
Uma partida jogada pelo LLM. O vídeo é gravado pela própria execução, sem ninguém no teclado.
03
A arquitetura
Um LLM recebe texto e devolve texto. Então o jogo precisava virar texto, e a jogada precisava voltar como texto que o código entendesse.
Antes do primeiro dia existe uma chamada só, fora do laço: o modelo lê as regras e define a estratégia da run, em até 260 caracteres, que vira a âncora de toda a partida. Depois, a cada dia, o código monta o contexto: essa estratégia, o estado do jogo, o que deu certo e o que deu errado ontem, e um caderno de anotações com o que o próprio modelo aprendeu até ali. O modelo devolve o plano do dia.
O plano não é texto livre. Criei uma gramática para ele: sete verbos (IR, COLHER, PLANTAR, FERTILIZAR, LIMPAR, COMPRAR, VENDER), quatro lugares e nenhuma coordenada. O modelo diz o que fazer, o interpretador executa.
O LLM decide, o interpretador conta.
A divisão é proposital. Escolher o cultivo, quanto comprar e em que ordem ir é estratégia, e fica com o modelo. Caminho, contagem de células e controle da estamina são aritmética, e ficam com o código, que confere antes de cada passo se ainda dá para voltar para casa.
IR canteiro_esquerdo       OK (17 passos)
COLHER TUDO                OK (20 células)
IR loja                    OK (26 passos)
VENDER batata TUDO         OK (16 un -> 79 moedas)
COMPRAR beterraba 9        OK (9 sementes -> 27 moedas)
IR canteiro_esquerdo       OK (21 passos)
PLANTAR beterraba TUDO     TRUNCADO_STAMINA: plantou 7 de 9
Dia 12 de uma partida do gemini-3.8-flash: o plano que o modelo escreveu, à esquerda, e o que o interpretador devolveu. O corte por estamina vira aviso no dia seguinte, não derrota.
Comando inválido não é reenviado ao modelo: é descartado, o resto do plano executa e o erro volta no relatório de amanhã. Reenviar esconderia o erro; reportar ensina.
A estratégia é pensada uma vez, antes do laço, e ancora a partida inteira. Dentro do laço, uma volta é um dia, e o caderno reescrito pelo modelo entra no prompt da volta seguinte: é por ele que a partida tem memória.
Antes do dia 1, uma chamada única pede ao LLM a estratégia da run, que entra em todo prompt da partida.
O código transforma o estado do jogo em prompt, junto com as regras, o feedback de ontem e o caderno de anotações.
O LLM devolve o plano do dia na gramática e reescreve o caderno com o que aprendeu.
O interpretador executa o plano, confere a estamina antes de cada passo e gera o feedback.
O resultado vira o estado do dia seguinte, e o laço recomeça.
04
Resultados
21 partidas completas, cada uma com o ano inteiro de jogo. Todas chegaram ao dia 121.
Além de pergunta e resposta
LLM costuma ficar restrito a receber mensagem e devolver resposta. Aqui ele testou um jogo inteiro: com uma gramática, as regras básicas e alguns tokens, faz o trabalho de um game tester a custo baixo.
Memória sem retreino
Cada chamada começa do zero, então a memória mora no caderno: o modelo registra o que aprendeu e confere se continua valendo. Sem centenas de épocas de treino para ensinar qual vegetal plantar, e sem o custo delas.
Custo e tempo
Com o OpenRouter testei vários modelos pela mesma interface e comparei quanto cada um devolve com um ou dois dólares, e quanto tempo leva para isso.
Custo, tempo e resultado de cada modelo numa partida de um ano
Modelo
Custo por ano
Tempo por chamada
Moedas ao fim
Dias cortados pela estamina
gpt-5.6-luna
US$ 0,29
13 s
≈ 1.140
5
gemini-3.8-flash
US$ 1,28
15 s
≈ 7.850
13
deepseek-v4.1-flash
US$ 0,75
73 s
≈ 5.940
37
Média das três sementes que os três modelos jogaram, cada partida com 121 dias.
A leitura não é a óbvia. O mais barato não foi o que jogou melhor: o gpt-5.6-luna custou um quarto do gemini e terminou o ano com um sétimo das moedas. E o mais lento não foi o mais caro: o deepseek levou cinco vezes mais tempo por chamada e custou pouco mais da metade do gemini.
05
Próximos passos
O primeiro não termina nunca: comparar mais modelos, conforme forem lançados. A estrutura já permite, é trocar o identificador do modelo e rodar as mesmas sementes.
O segundo é o mais interessante. Aumentar as regras do jogo, pôr mais restrições, e ver como os LLMs se comportam quando a partida fica mais difícil. Saber onde um modelo começa a errar diz mais sobre ele do que saber onde ele acerta.